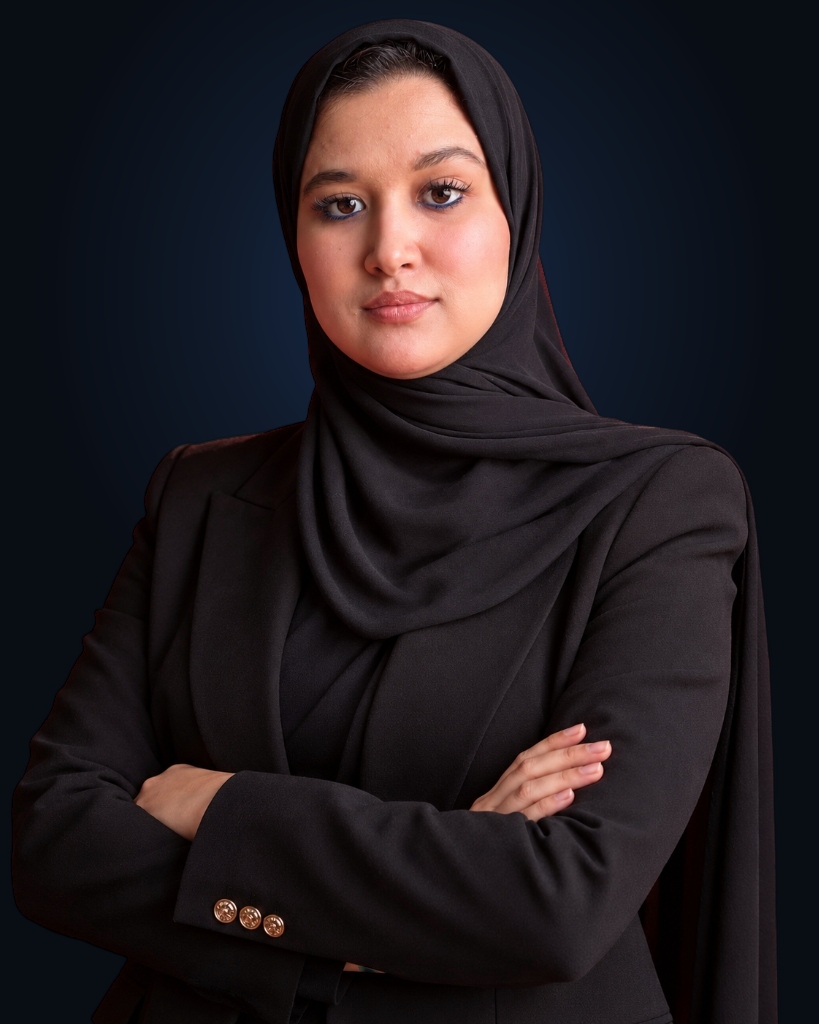
Ingénieure en Intelligence Artificielle & Développement LogicielArtificial Intelligence & Software Engineer
Étudiante en Master Intelligence Artificielle et Systèmes de Décision Optimale à Meknès. Je conçois des systèmes d'IA appliqués, des architectures logicielles robustes et des modèles d'optimisation mathématique de bout en bout. Spécialisée en recherche opérationnelle (Google OR-Tools CP-SAT), modélisation prédictive, RAG vectoriel et ingénierie logicielle full-stack.Master's student in Artificial Intelligence and Optimal Decision Systems in Meknès, Morocco. I design applied AI systems, robust software architectures, and end-to-end mathematical optimization models. Specialized in operations research (Google OR-Tools CP-SAT), predictive modeling, vector RAG, and full-stack software engineering.
Relier l’analyse à la réalisation.Connecting analysis with implementation.
Comprendre la donnée, choisir l'approche technique, construire le logiciel et évaluer ses limites.Understanding the data, choosing an approach, building the application and evaluating its limitations.
🔬
Parcours académique & curiositéAcademic foundation
Ma formation associe génie informatique, systèmes intelligents et recherche opérationnelle. Je m’intéresse à la trajectoire complète qui mène d’un problème à une solution concrète : comprendre la donnée, modéliser les contraintes mathématiques, développer l’application et mesurer honnêtement ses limites.My background spans computer engineering, intelligent systems and operations research. I’m interested in the complete path from a problem to a working solution: understanding data, formulating mathematical constraints, building software and evaluating limitations.
⚡
Expérience pratique & équipePractical impact
Lors de mon stage chez Arimas Holdings, j’ai exercé comme team leader et ingénieure IA/logiciel sur Tadbir AI. Mon activité freelance m’a également appris à nettoyer, structurer et automatiser des flux de données répondant à de réels besoins métier.During my internship at Arimas Holdings, I worked as a team leader and AI/software engineering intern on Tadbir AI. My freelance work has also given me experience preparing and structuring data for practical business needs.
💡
Philosophie & transparenceEngineering philosophy
Mes projets explorent l'optimisation combinatoire (OR-Tools CP-SAT), le machine learning, le RAG vectoriel et la cybersécurité. À travers ce portfolio, je partage ce que je construis, les décisions qui sous-tendent chaque choix et les enseignements tirés en chemin.My projects explore combinatorial optimization (OR-Tools CP-SAT), machine learning, vector RAG and cybersecurity. Through this portfolio, I share what I build, the decisions behind it and what I learn along the way.
02 / PROJETS SÉLECTIONNÉSSELECTED PROJECTS
Quatre études de cas approfondies.Four in-depth case studies.
BidPilot AI, ResearchOS, Analyste IA multi-agents et V2C-Sentinel : explorez les décisions d'architecture et les détails d'implémentation.BidPilot AI, ResearchOS, Multi-Agent AI Analyst and V2C-Sentinel: explore the architectural choices and technical implementations.
AIDE À LA DÉCISION · NLP & GOOGLE OR-TOOLS CP-SAT
BidPilot AI
Système d’aide à la décision pour les achats · Optimisation CP-SAT & Matching NLPEnterprise Procurement Decision Support · CP-SAT Optimization & NLP Matching
Application d’aide à la décision pour les appels d’offres (RFQ) combinant le matching sémantique par embeddings NLP (Sentence-Transformers) et l’optimisation mathématique discrète exacte avec Google OR-Tools CP-SAT pour minimiser le coût d’achat total sous contraintes de délais, capacités fournisseurs et quantités minimales (MOQ).Enterprise decision-support application for industrial RFQ quotations coupling NLP semantic embeddings with exact discrete mathematical optimization (Google OR-Tools CP-SAT) to minimize procurement spend under delivery deadlines, supplier capacities, and minimum order quantities (MOQs).
Architecture logicielle et modélisation mathématique complète : pipeline de vectorisation et réconciliation sémantique des devis fournisseurs non standardisés, formulation du programme d’optimisation discrète avec Google OR-Tools CP-SAT et détection d’infaisabilité, API asynchrone FastAPI et tableau de bord Next.js / TypeScript.Full-stack software architecture and mathematical modeling: NLP semantic matching pipeline reconciling non-standard supplier quotations, discrete CP-SAT formulation with infeasibility diagnostics in Google OR-Tools, asynchronous FastAPI backend, and Next.js / TypeScript dashboard.
Sélection du solveur Google OR-Tools CP-SAT (Constraint Programming over Finite Domains) plutôt qu’un solveur MIP linéaire classique afin de modéliser nativement les contraintes logiques disjonctives (coûts fixes d’activation de fournisseur, MOQ discontinues). Utilisation d’embeddings locaux pour une latence d’inférence maîtrisée.Selected Google OR-Tools CP-SAT solver over standard linear MIP solvers to natively model disjunctive logic constraints (supplier activation fixed costs, discontinuous minimum order quantities) without heuristic relaxation.
RAG · RECHERCHE DOCUMENTAIRE · PGVECTOR
ResearchOS
Recherche documentaire avec RAG et réponses sourcées · Comparaison de modèlesDocument retrieval with RAG and sourced answers · Model benchmarking
Recherche documentaire avec génération augmentée par recherche (RAG) et réponses sourcées ; comparaison de modèles prédictifs. FastAPI, Next.js, pgvector.Document retrieval with Retrieval-Augmented Generation (RAG) and sourced answers; predictive model benchmarking. FastAPI, Next.js, pgvector.
Architecture logicielle et développement complet : pipeline d’ingestion et de vectorisation des documents avec pgvector, API asynchrone FastAPI, interface utilisateur Next.js et banc d’évaluation comparatif des modèles de prédiction et de réponse.Full-stack architecture and engineering: document chunking and vector indexing pipeline using pgvector, asynchronous FastAPI backend, Next.js interface, and comparative model benchmarking.
Choix de PostgreSQL + pgvector pour regrouper les métadonnées relationnelles et les vecteurs au sein d’une même infrastructure transactionnelle sans complexité opérationnelle superflue, couplé à FastAPI pour le streaming temps réel.Selected PostgreSQL + pgvector to consolidate relational metadata and dense vectors in a unified database, combined with FastAPI for asynchronous streaming.
SYSTÈMES MULTI-AGENTS · LANGGRAPH & DUCKDB
Analyste IA multi-agents
Système collaboratif de 6 agents pour l’analyse de données et le reporting automatiséCollaborative 6-agent system for data analysis, verification and reporting
Conception d’un système de 6 agents pour analyser les données, vérifier les résultats et produire des graphiques et des rapports. LangGraph, DuckDB, Polars, Gemini.Design of a 6-agent system to analyze data, verify results, and generate charts and reports. LangGraph, DuckDB, Polars, Gemini.
Conception intégrale de l’architecture multi-agents sous LangGraph, formulation des rôles spécialisés, orchestration de l’état partagé et optimisation des calculs analytiques in-memory avec DuckDB et Polars.Designed and implemented the complete LangGraph multi-agent architecture, authored discrete agent prompt contracts, managed execution state persistence, and accelerated in-memory data operations with DuckDB and Polars.
Choix d’un graphe d’états déterministe avec points de contrôle sous LangGraph plutôt qu’une chaîne linéaire opaque, et association DuckDB + Polars pour exécuter des requêtes analytiques massives avec une empreinte mémoire minimale.Selected LangGraph for cycle-aware state transitions and safety checkpoints, paired with DuckDB and Polars for columnar speed without database overhead.
MACHINE LEARNING · CYBERSECURITY · SIMULATION
V2C-Sentinel
Prototype de recherche · Détection d’intrusions CAN & contraintes 5GResearch prototype · CAN intrusion detection under 5G constraints
Détection d’intrusions CAN (Controller Area Network) en simulation locale : requêtes de confirmation limitées et délais 5G rejoués. Python, régression logistique, forêt aléatoire.CAN (Controller Area Network) intrusion detection under local simulation: constrained confirmation requests and replayed 5G delays. Python, logistic regression, random forest.
Recherche et développement logiciel : conception de l’architecture à deux niveaux, extraction des caractéristiques temporelles des trames CAN, entraînement des modèles locaux et simulation des distributions de latence 5G.Research and software development: dual-tier architecture design, CAN frame feature extraction, training detection classifiers, and simulating 5G delay distributions.
Adopter une approche hiérarchique pour concilier rapidité de réaction locale et économie de bande passante, plutôt que d’envoyer chaque trame dans le cloud ou de surcharger le microcontrôleur embarqué.Adopted a hierarchical tier to balance immediate on-vehicle reaction with constrained cloud bandwidth, rather than saturating the network or vehicle ECU.
03 / AUTRES PROJETS GITHUBMORE GITHUB PROJECTS
Cinq projets d'ingénierie & d'optimisation.Five engineering & optimization projects.
FlowDesk AI, Tadbir AI, pipeline MLOps de bout en bout, intelligence de tarification e-commerce et optimisation logistique.FlowDesk AI, Tadbir AI, end-to-end MLOps pipeline, e-commerce pricing intelligence and logistics optimization.
Filtrer :Filter:
01SERVICE MANAGEMENT · ML & OR-TOOLS CP-SAT
Gestion des services & PlanificationService management & Workforce scheduling
FlowDesk AI
Classification automatique et affectation optimale des effectifs.Automated ticket categorization and optimal staff assignment.
Une plateforme ITSM intelligente qui allie classification de tickets par machine learning (TF-IDF + Régression Logistique) et programmation mathématique par contraintes (Google OR-Tools CP-SAT) pour l’affectation d’agents sous contraintes de compétences, disponibilités et SLA.An intelligent ITSM platform coupling machine learning ticket categorization (TF-IDF + Logistic Regression) with exact constraint programming (Google OR-Tools CP-SAT) for staff scheduling under skills, availability, and SLA targets.
Classifieur NLP rapide (<10ms), solveur CP-SAT avec équilibrage de charge et API FastAPI.Sub-10ms NLP classifier, CP-SAT solver with workload balancing, and asynchronous FastAPI backend.
Cadre & validationProject scope & validation
Prototype d’ingénierie évalué sur données d’incidents synthétiques réalistes avec métriques de classification documentées.Engineering prototype evaluated on synthetic incident backlogs with documented classification metrics.
Logiciel de gestion métier assisté par l’IAAI-assisted business software
Tadbir AI
Automatisation des flux administratifs et facturation.Streamlining administrative workflows and invoicing.
Une plateforme collaborative développée chez Arimas Holdings réunissant facturation, suivi client, gestion des stocks et reporting, avec extraction documentaire assistée par IA et import de tableurs.A collaborative business-management platform developed during my internship at Arimas Holdings bringing together invoicing, customer management, inventory and reporting, with AI document extraction and spreadsheet imports.
PythonDjango RESTNext.jsTypeScriptGemini
Méthodologie & PérimètreApproach & Scope
Approche techniqueTechnical approach
Rôle de Team Leader et ingénieure stagiaire : API Django REST, validation de schémas et intégration Gemini.Team Leader & Engineering Intern: Django REST APIs, schema validation and Gemini orchestration.
Cadre & validationProject scope & validation
Projet d’équipe réalisé en stage chez Arimas Holdings (juillet–septembre 2026).Team project delivered during internship at Arimas Holdings (July–September 2026).
De la préparation de données à la détection de dérive.From data preparation to drift monitoring.
Un pipeline complet autour du jeu Telco Churn : versioning DVC, suivi des expérimentations MLflow, API d’inférence FastAPI sous Docker et monitoring de distribution avec tests KS et PSI.An end-to-end churn prediction pipeline using the Telco dataset: DVC versioning, MLflow tracking, Dockerized FastAPI inference endpoint, and KS/PSI distribution monitoring.
PythonScikit-learnDVCMLflowFastAPIDocker
Méthodologie & PérimètreApproach & Scope
Approche techniqueTechnical approach
Reproductibilité complète, conteneurisation Docker et tests statistiques de dérive.Full pipeline reproducibility, Docker containerization and statistical drift detection.
Cadre & validationProject scope & validation
Projet individuel avec exécution locale documentée et pipeline de réentraînement.Personal project with documented local execution and automated retraining criteria.
De 1M+ transactions à des analyses décisionnelles.From 1M+ transactions to business intelligence.
Une application analytique construite autour du jeu public Online Retail II (>1 million de transactions). Elle explore la segmentation RFM, la classification ABC-XYZ, les prévisions de revenus avec Prophet et les corrélations prix-demande dans un tableau de bord web interactif.An e-commerce analytics application built using the public Online Retail II dataset (>1 million transactions). It explores customer RFM segmentation, product classification, revenue forecasting with Prophet, and price-demand relationships in an interactive dashboard.
PythonDuckDBSQLFastAPIProphetChart.js
Méthodologie & PérimètreApproach & Scope
Approche techniqueTechnical approach
Segmentation vectorisée avec DuckDB, API FastAPI et visualisation Chart.js.Vectorized segmentation with DuckDB, FastAPI backend and Chart.js visualization.
Cadre & validationProject scope & validation
Projet analytique d’exploration. La corrélation prix-demande est observationnelle et ne démontre pas une élasticité causale ni un gain commercial réel.Exploratory analytics project. Price-demand correlation is observational and does not claim causal elasticity or commercial gains.
Aide à la décision logistique sous contraintes.Decision-support dashboard under operational constraints.
Un tableau de bord interactif pour explorer des scénarios d’approvisionnement et d’allocation de ressources. Formulation en programmation linéaire, optimisation multi-objectifs, modélisation de l’incertitude, simulation de Monte-Carlo et analyses de sensibilité.An interactive dashboard for exploring procurement and resource allocation decisions under constraints, using linear programming, multi-objective trade-offs, Monte Carlo simulation, and sensitivity analysis.
PythonPuLPStreamlitPlotly
Méthodologie & PérimètreApproach & Scope
Approche techniqueTechnical approach
Programmation mathématique PuLP et visualisations interactives Plotly/Streamlit.Mathematical optimization using PuLP with Plotly and Streamlit interactive interfaces.
Cadre & validationProject scope & validation
Étude de cas par simulation : les scénarios modélisent des compromis mathématiques et ne représentent pas des économies mesurées chez un client.Simulation-based study: scenarios explore constraint boundaries rather than verified commercial savings.
Stages & Activité freelance.Experience in teams & consulting.
Une pratique alliant conduite de projet, intégration logicielle et traitement rigoureux des données.Combining team coordination, software development and rigorous data processing.
Arimas Holdings
Team Leader · Ingénieure IA / Logiciel stagiaireTeam Leader · AI / Software Engineering Intern
Travail avec une équipe de développement sur Tadbir AI, une plateforme de gestion d’entreprise intégrant des capacités d’IA. Coordination d’équipe combinée à des contributions concrètes au développement logiciel et à l’extraction de documents.Worked with a development team on Tadbir AI, a business-management platform incorporating AI capabilities. Combined team coordination with contributions to AI and software development.
EUMATRIX.eu · Upwork
Data Analyst freelanceFreelance Data Analyst
Collecte de jeux de données ciblés pour le marché danois ; nettoyage, transformation et structuration des données avec Python et SQL. Contribution à la validation des données et à l’automatisation des workflows, avec une mission renouvelée par le client.Collected targeted datasets for the Danish market and cleaned, transformed and structured data using Python and SQL. Contributed to data validation and workflow automation, including a follow-up engagement with the same client.
EST Meknès
Stagiaire en développement logicielSoftware Development Intern
Développement d’une application PHP/MySQL de génération automatique d’emplois du temps, déployée et utilisée au sein de trois départements académiques. Rédaction de la documentation d’utilisation et de maintenance.Developed a PHP/MySQL timetable-generation application used across three departments. Produced user and maintenance documentation.
Support des outils informatiques internes, assistance à la résolution d’incidents techniques et préparation de guides documentaires pour les utilisateurs.Supported internal tools, helped resolve technical incidents and prepared documentation for users.
05 / DOMAINES DE COMPÉTENCESAREAS OF PRACTICE
Expertise & Méthodes de travail.Core competencies & toolsets.
Quatre piliers techniques reliant analyse, modélisation, mise en production et optimisation mathématique.Four technical pillars connecting analysis, modeling, software deployment and mathematical optimization.
01 / DATA
Analyse de donnéesData analysis
Préparer, explorer et structurer des volumes de données pour appuyer des analyses décisionnelles utiles.Preparing, exploring and structuring data to support useful analysis.
Comparer méthodiquement les modèles prédictifs, concevoir des architectures RAG et orchestrer des agents autonomes.Systematically benchmarking predictive models, engineering vector RAG systems and orchestrating autonomous agents.
Scikit-learn · LangGraph · pgvector · Sentence-Transformers · Gemini API
03 / SOFTWARE & MLOPS
Logiciel & MLOpsSoftware and MLOps
Relier modèles et données aux applications réelles, avec des APIs rapides, du suivi d'expériences et du code reproductible.Connecting models and data to applications, with APIs, experiment tracking and reproducible environments.
Formuler des contraintes mathématiques discrètes et linéaires, modéliser l’incertitude et optimiser les décisions opérationnelles.Formulating discrete and linear constraints, modeling uncertainty and optimizing operational decisions.
Notes sur les expérimentations, les choix d’implémentation et les enseignements tirés sur le terrain.Notes on experiments, implementation choices and lessons from working with data, AI and software.
Format d’analyse rigoureux :Analytical article structure:
Le problème formulé → L’approche testée → L’expérimentation → Ce que les données ont montré → Limites & suites.The problem formulation → Approach tested → Implementation/experiment → Empirical findings → Limitations & next steps.
OR-TOOLS CP-SAT & NLP
Optimisation discrète avec Google OR-Tools CP-SAT et matching NLPDiscrete optimization with Google OR-Tools CP-SAT and NLP matching
Comment modéliser les coûts fixes et seuils MOQ en programmation par contraintes disjonctives tout en réconciliant les devis par similarité vectorielle.Modeling fixed supplier costs and MOQ thresholds in disjunctive constraint programming while reconciling RFQ lines with semantic embeddings.
RAG & pgvector : sourçage strict et réduction des hallucinationsRAG with pgvector: strict sourcing and hallucination mitigation
Comment structurer l’indexation vectorielle dans PostgreSQL avec pgvector et contraindre les réponses du modèle génératif à des citations documentaires vérifiables.Structuring vector indexing in PostgreSQL with pgvector and strictly grounding generative model responses in verifiable document citations.
Orchestrer 6 agents autonomes avec LangGraph, DuckDB et PolarsOrchestrating 6 autonomous agents with LangGraph, DuckDB and Polars
Architecture d’un graphe d’états à 6 agents pour l’analyse de données : division des responsabilités, boucle d’audit croisée et exécution analytique en mémoire.Designing a 6-agent state graph for automated analytics: role decomposition, mutual critique loops, and fast in-memory execution with DuckDB and Polars.
Compromis entre détection et communication dans V2C-SentinelDetection and communication trade-offs in V2C-Sentinel
Quand la bande passante 5G est comptée : arbitrer mathématiquement entre le risque de faux négatifs locaux et l’épuisement du quota de requêtes vers le cloud.When 5G bandwidth is constrained: balancing local false-negative risks against cloud request quotas under variable latency distributions.
FlowDesk AI : Coupler classification Scikit-learn et affectation CP-SATFlowDesk AI: Coupling Scikit-learn ML routing with CP-SAT team assignment
Associer la prédiction statistique des catégories de tickets aux contraintes dures de compétences et d’équité de charge hebdomadaire.Bridging statistical ticket categorization with hard operational constraints on technician certifications and weekly workload fairness.
Du modèle de churn à l’API de prédiction et surveillance de dériveFrom a churn model to a prediction API and drift monitoring
Pourquoi un notebook ne suffit pas : structurer l’inférence avec FastAPI, gérer la sérialisation des pipelines et surveiller la dérive avec KS et PSI.Why a notebook is only the first step: packaging inference endpoints with FastAPI, managing pipeline artifacts, and tracking drift with KS and PSI.
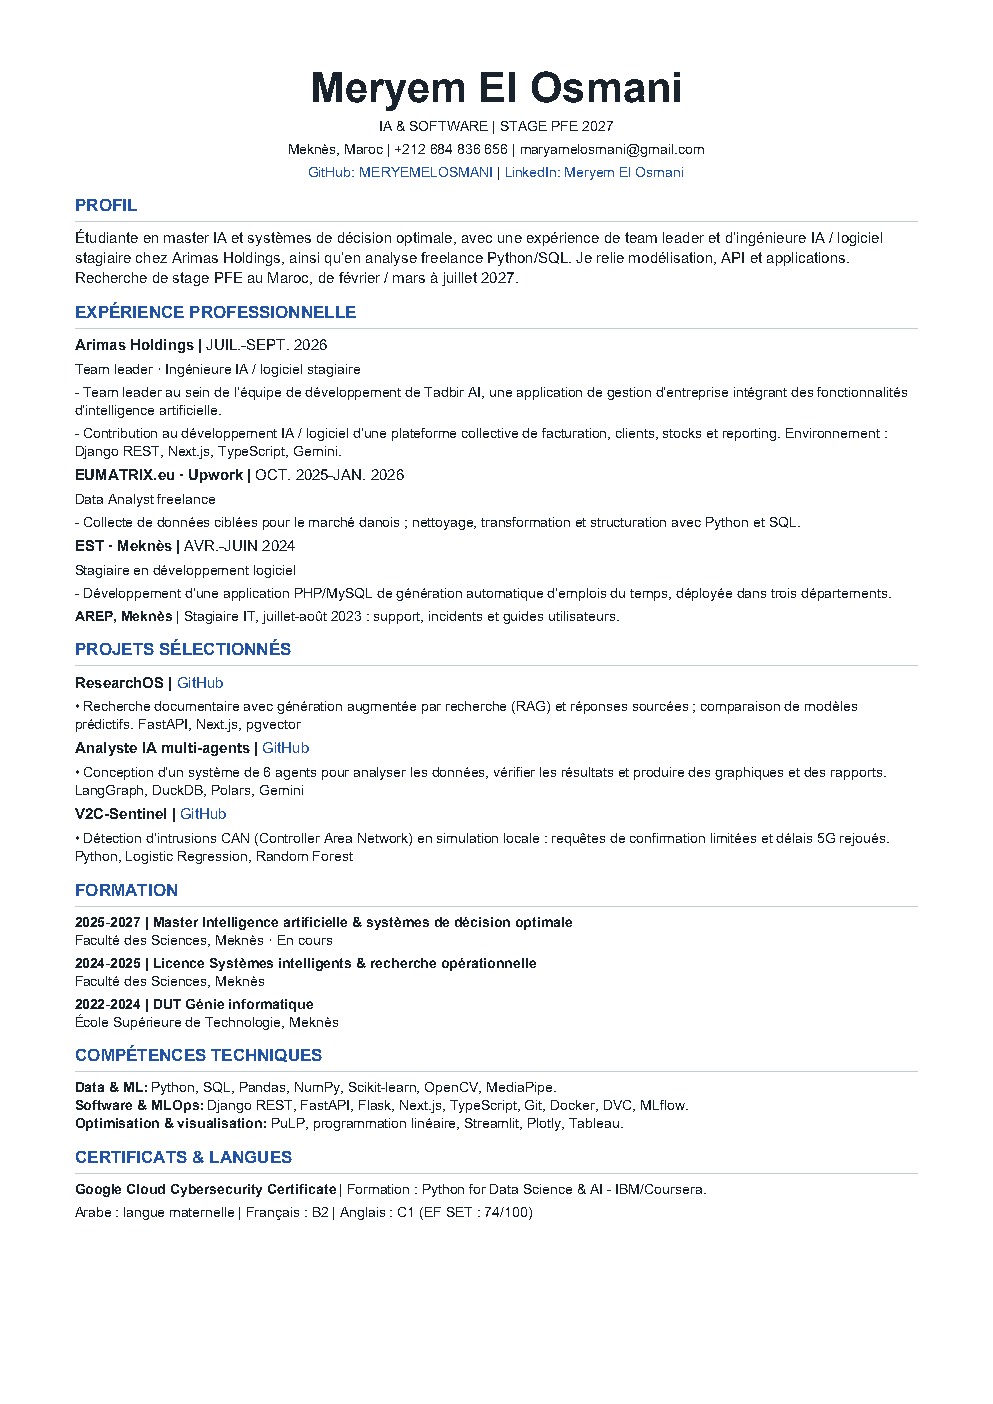
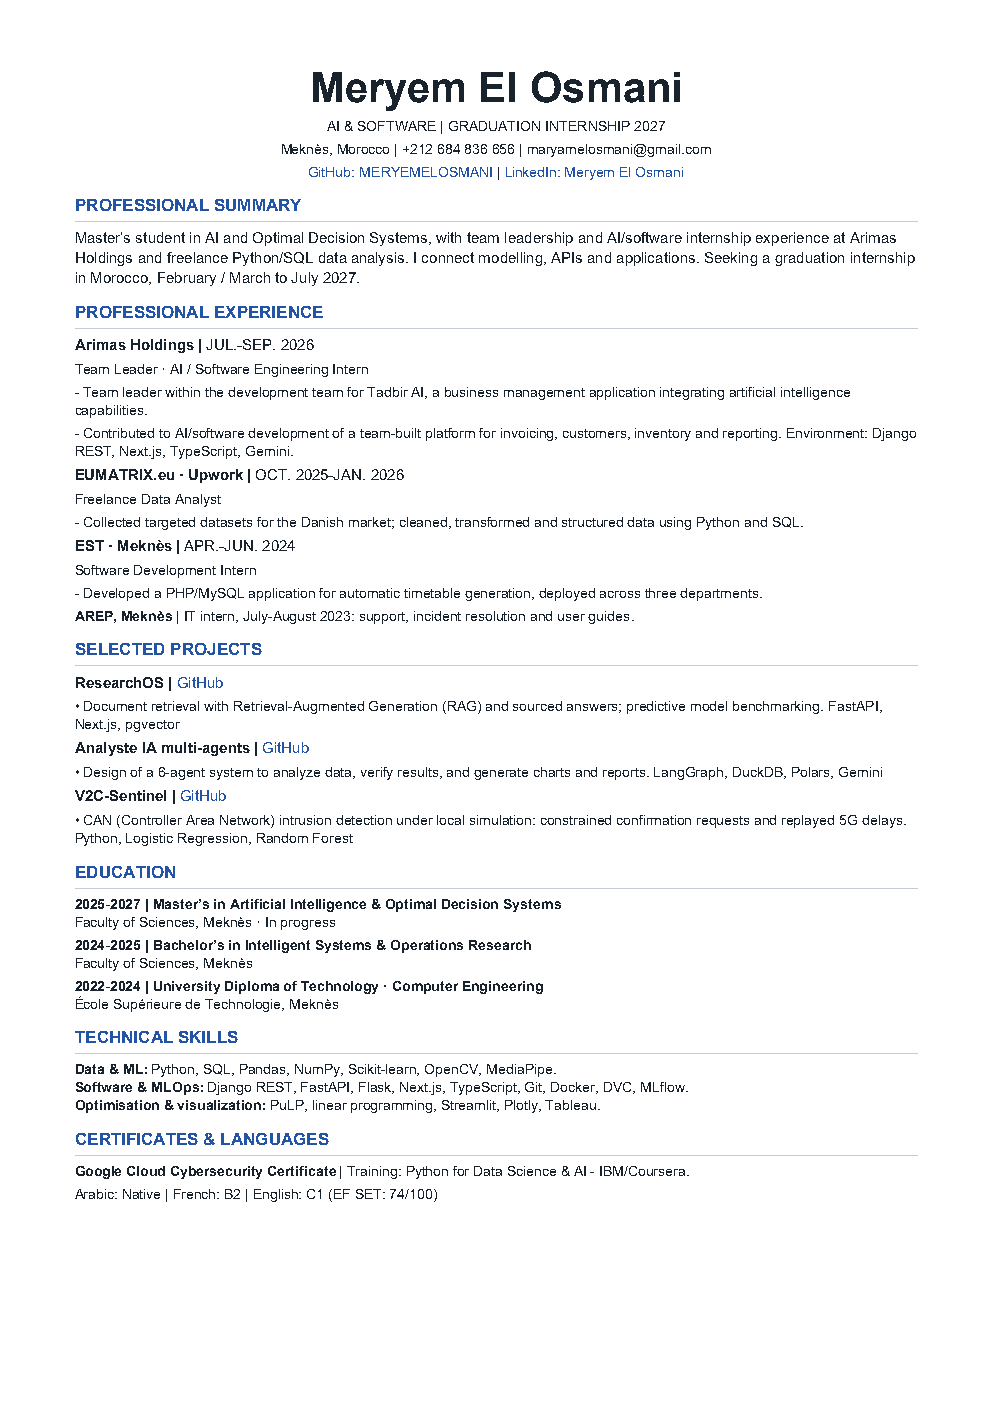
Curriculum Vitae — Synthèse 1 Page A4Curriculum Vitae — 1-Page Focused Resume
Conçu pour les recruteurs techniques et responsables d'équipe : une synthèse dense et lisible reliant modélisation IA, ingénierie logicielle et expérience concrète.Crafted for technical recruiters and engineering managers: a concise 1-page synthesis connecting AI modeling, software engineering and real-world execution.
Échangeons sur ce que nous pourrions construire.Let’s discuss what we could build.
Je recherche un stage de fin d’études (PFE) au Maroc de février / mars à juillet 2027 en IA appliquée, recherche opérationnelle ou ingénierie logicielle. Si votre équipe recherche quelqu’un qui aime relier l’analyse à la réalisation, je serais ravie d’échanger sur vos projets et sur ma contribution.I’m seeking a final-year internship in Morocco in applied AI, operations research or software engineering. If your team is looking for someone who enjoys connecting analysis with implementation, I’d be happy to discuss your work and how I could contribute.
Disponibilité :Availability:Février / Mars à Juillet 2027February / March to July 2027
Système d’aide à la décision pour les achats · Optimisation CP-SAT & Matching NLPEnterprise Procurement Decision Support · CP-SAT Optimization & NLP Matching
1. Vue d’ensemble (Overview)Overview
Application d’aide à la décision pour les appels d’offres (RFQ) combinant le matching sémantique par embeddings NLP (Sentence-Transformers) et l’optimisation mathématique discrète exacte avec Google OR-Tools CP-SAT pour minimiser le coût d’achat total sous contraintes de délais, capacités fournisseurs et quantités minimales (MOQ).Enterprise decision-support application for industrial RFQ quotations coupling NLP semantic embeddings with exact discrete mathematical optimization (Google OR-Tools CP-SAT) to minimize procurement spend under delivery deadlines, supplier capacities, and minimum order quantities (MOQs).
Architecture logicielle et modélisation mathématique complète : pipeline de vectorisation et réconciliation sémantique des devis fournisseurs non standardisés, formulation du programme d’optimisation discrète avec Google OR-Tools CP-SAT et détection d’infaisabilité, API asynchrone FastAPI et tableau de bord Next.js / TypeScript.Full-stack software architecture and mathematical modeling: NLP semantic matching pipeline reconciling non-standard supplier quotations, discrete CP-SAT formulation with infeasibility diagnostics in Google OR-Tools, asynchronous FastAPI backend, and Next.js / TypeScript dashboard.
3. Fonctionnement & Architecture (How It Works)How It Works
Les lignes de devis fournisseurs bruts sont transformées en embeddings vectoriels et associées aux lignes de la demande d’achat par similarité cosinus avec seuil de confiance et arbitrage humain. Le solveur CP-SAT prend les correspondances validées et résout un programme d’optimisation discrète pour déterminer les volumes exacts alloués à chaque fournisseur tout en respectant les MOQ, capacités maximales et fenêtres de livraison.Unstructured supplier quotation lines are embedded and matched against RFQ specifications using cosine similarity with confidence thresholds and manual override capability. The CP-SAT solver ingests verified pairings and solves a discrete constraint programming model to allocate quantities across suppliers, strictly respecting MOQs, volume caps, and delivery schedules.
Sélection du solveur Google OR-Tools CP-SAT (Constraint Programming over Finite Domains) plutôt qu’un solveur MIP linéaire classique afin de modéliser nativement les contraintes logiques disjonctives (coûts fixes d’activation de fournisseur, MOQ discontinues). Utilisation d’embeddings locaux pour une latence d’inférence maîtrisée.Selected Google OR-Tools CP-SAT solver over standard linear MIP solvers to natively model disjunctive logic constraints (supplier activation fixed costs, discontinuous minimum order quantities) without heuristic relaxation.
5. Évaluation & Mesures (Evaluation)Evaluation
Benchmark sur des scénarios de simulation d’achats industriels : comparaison des coûts optimisés par rapport à une allocation gloutonne baseline, validation de la détection d’infaisabilité budgétaire et tests de sensibilité aux variations de prix fournisseurs.Benchmarked across industrial procurement simulation scenarios: quantified cost reductions against greedy baseline allocations, rigorously verified infeasibility detection under tight budget caps, and performed parameter sensitivity tests.
6. Limites identifiées (Limitations)Limitations
Prototype de recherche et d’ingénierie évalué sur des données synthétiques contrôlées. Ne comprend pas de connecteur direct vers un progiciel ERP en production (SAP/Oracle).Local portfolio prototype operating on synthetic RFQ data. Multi-user authentication and hardened cloud deployment are outside the demonstration scope.
Dans les systèmes d’aide à la décision critique, la transparence algorithmique et l’explication des causes d’infaisabilité sont tout aussi essentielles aux décideurs que la valeur de la fonction objectif.In mission-critical decision support, algorithmic interpretability and actionable infeasibility diagnostics matter just as much to stakeholders as raw cost minimization.
8. Explorer le projet & Code source (Explore Further)Explore Further
Accédez au dépôt officiel sur GitHub pour examiner le code source, l’architecture et les instructions d’exécution :Explore the official GitHub repository for source code, architecture specifications, and local execution guides:
Recherche documentaire avec RAG et réponses sourcées · Comparaison de modèlesDocument retrieval with RAG and sourced answers · Model benchmarking
1. Vue d’ensemble (Overview)Overview
Recherche documentaire avec génération augmentée par recherche (RAG) et réponses sourcées ; comparaison de modèles prédictifs. FastAPI, Next.js, pgvector.Document retrieval with Retrieval-Augmented Generation (RAG) and sourced answers; predictive model benchmarking. FastAPI, Next.js, pgvector.
Architecture logicielle et développement complet : pipeline d’ingestion et de vectorisation des documents avec pgvector, API asynchrone FastAPI, interface utilisateur Next.js et banc d’évaluation comparatif des modèles de prédiction et de réponse.Full-stack architecture and engineering: document chunking and vector indexing pipeline using pgvector, asynchronous FastAPI backend, Next.js interface, and comparative model benchmarking.
3. Fonctionnement & Architecture (How It Works)How It Works
Les documents sont découpés en fragments sémantiques et transformés en embeddings vectoriels indexés dans PostgreSQL avec pgvector. Lors d’une requête, une recherche de similarité cosinus extrait les passages les plus pertinents et les fournit au modèle génératif pour synthétiser des réponses étayées par des citations de sources vérifiables.Technical documents are chunked and converted into high-dimensional embeddings stored in PostgreSQL with pgvector. A natural language query triggers cosine similarity search to retrieve grounded snippets, allowing the generative model to synthesize verified, source-cited responses.
Choix de PostgreSQL + pgvector pour regrouper les métadonnées relationnelles et les vecteurs au sein d’une même infrastructure transactionnelle sans complexité opérationnelle superflue, couplé à FastAPI pour le streaming temps réel.Selected PostgreSQL + pgvector to consolidate relational metadata and dense vectors in a unified database, combined with FastAPI for asynchronous streaming.
5. Évaluation & Mesures (Evaluation)Evaluation
Évaluation de la pertinence des extraits récupérés (Recall@k, MRR) et élimination des hallucinations factuelles grâce à une consigne stricte de sourçage obligatoire.Benchmarked retrieval fidelity (Recall@k, MRR) and verified source grounding to eliminate unverified hallucinations.
6. Limites identifiées (Limitations)Limitations
La précision dépend de la stratégie de segmentation des documents (chunking) et du comportement des embeddings face aux termes scientifiques hautement spécialisés.Performance is sensitive to document chunking granularity and domain vocabulary coverage in the embedding space.
L’ingénierie de la récupération (retrieval) et la qualité du nettoyage amont des données priment toujours sur la taille brute du modèle pour garantir des réponses exactes et fiables.Rigorous retrieval curation and clean document chunking contribute far more to reliability than raw LLM scale.
8. Explorer le projet & Code source (Explore Further)Explore Further
Accédez au dépôt officiel sur GitHub pour examiner le code source, l’architecture et les instructions d’exécution :Explore the official GitHub repository for source code, architecture specifications, and local execution guides:
Système collaboratif de 6 agents pour l’analyse de données et le reporting automatiséCollaborative 6-agent system for data analysis, verification and reporting
1. Vue d’ensemble (Overview)Overview
Conception d’un système de 6 agents pour analyser les données, vérifier les résultats et produire des graphiques et des rapports. LangGraph, DuckDB, Polars, Gemini.Design of a 6-agent system to analyze data, verify results, and generate charts and reports. LangGraph, DuckDB, Polars, Gemini.
Conception intégrale de l’architecture multi-agents sous LangGraph, formulation des rôles spécialisés, orchestration de l’état partagé et optimisation des calculs analytiques in-memory avec DuckDB et Polars.Designed and implemented the complete LangGraph multi-agent architecture, authored discrete agent prompt contracts, managed execution state persistence, and accelerated in-memory data operations with DuckDB and Polars.
3. Fonctionnement & Architecture (How It Works)How It Works
Six agents spécialisés collaborent selon un graphe d’états LangGraph : (1) Superviseur & Planificateur, (2) Ingestion & Profilage DuckDB, (3) Transformation Polars, (4) Validation Statistique, (5) Visualisation graphique, et (6) Rédacteur de Synthèse. Un sous-graphe de vérification audite les calculs avant toute génération de rapport.Six specialized agents collaborate across a stateful LangGraph workflow: (1) Supervisor/Planner, (2) DuckDB Ingestion & Profiler, (3) Polars Transformer, (4) Statistical Verification, (5) Chart Generator, and (6) Report Synthesizer. An auditing cycle verifies computations before delivering final documents.
Choix d’un graphe d’états déterministe avec points de contrôle sous LangGraph plutôt qu’une chaîne linéaire opaque, et association DuckDB + Polars pour exécuter des requêtes analytiques massives avec une empreinte mémoire minimale.Selected LangGraph for cycle-aware state transitions and safety checkpoints, paired with DuckDB and Polars for columnar speed without database overhead.
5. Évaluation & Mesures (Evaluation)Evaluation
Tests sur des séries de données réelles complexes avec anomalies injectées : la boucle d’auto-critique entre agents a permis de réduire drastiquement les erreurs de calcul par rapport aux agents solitaires.Evaluated against multi-table datasets with messy formats; the multi-agent critique loop eliminated mathematical hallucinations common in single-agent architectures.
6. Limites identifiées (Limitations)Limitations
Exige un bac à sable (sandboxing) strict pour l’exécution de scripts Python générés et un monitoring précis des quotas d’appels à l’API Gemini.Requires secure sandboxed runtime environments for dynamic Python code execution and careful rate limiting for Gemini API tokens.
La décomposition en rôles étroits et mutuellement vérifiables surpasse largement les approches à invite unique pour les tâches analytiques critiques.Specialized modular agents with explicit validation loops provide significantly greater analytical reliability than monolithic prompts.
8. Explorer le projet & Code source (Explore Further)Explore Further
Accédez au dépôt officiel sur GitHub pour examiner le code source, l’architecture et les instructions d’exécution :Explore the official GitHub repository for source code, architecture specifications, and local execution guides:
Prototype de recherche · Détection d’intrusions CAN & contraintes 5GResearch prototype · CAN intrusion detection under 5G constraints
1. Vue d’ensemble (Overview)Overview
Détection d’intrusions CAN (Controller Area Network) en simulation locale : requêtes de confirmation limitées et délais 5G rejoués. Python, régression logistique, forêt aléatoire.CAN (Controller Area Network) intrusion detection under local simulation: constrained confirmation requests and replayed 5G delays. Python, logistic regression, random forest.
Recherche et développement logiciel : conception de l’architecture à deux niveaux, extraction des caractéristiques temporelles des trames CAN, entraînement des modèles locaux et simulation des distributions de latence 5G.Research and software development: dual-tier architecture design, CAN frame feature extraction, training detection classifiers, and simulating 5G delay distributions.
3. Fonctionnement & Architecture (How It Works)How It Works
Un premier modèle local léger (régression logistique) surveille les flux CAN en temps réel avec une latence quasi nulle. En cas d’anomalie suspectée et si le budget de requêtes le permet, une trame est transmise à un modèle de confirmation plus lourd (Random Forest) via une simulation de latence 5G rejouée.A lightweight local warning model (logistic regression) inspects CAN frames in real time with near-zero latency. If an anomaly is flagged and the request budget allows, the sequence is forwarded to a deeper confirmation model (random forest) through replayed 5G latency distributions.
Adopter une approche hiérarchique pour concilier rapidité de réaction locale et économie de bande passante, plutôt que d’envoyer chaque trame dans le cloud ou de surcharger le microcontrôleur embarqué.Adopted a hierarchical tier to balance immediate on-vehicle reaction with constrained cloud bandwidth, rather than saturating the network or vehicle ECU.
5. Évaluation & Mesures (Evaluation)Evaluation
Simulation logicielle sur des enregistrements réels de trames CAN normales et injectées d’attaques. Mesure de la réduction des fausses alertes et du respect du quota de communication selon différents budgets imposés.Simulated across CAN logs containing normal traffic and injected attack patterns, quantifying false-alarm mitigation under varying query quotas.
6. Limites identifiées (Limitations)Limitations
Étude de cas réalisée par simulation logicielle locale. Aucun véhicule physique ni antenne 5G réelle n’a été utilisé ; les délais sont issus de distributions statistiques mesurées.Simulation-based study using recorded data and replayed network latency. Does not reflect hardware-in-the-loop vehicle deployment.
La sécurité automobile exige d’évaluer conjointement les métriques de machine learning (F1-score) et les contraintes cyber-physiques (délai de réaction, bande passante disponible).Automotive cybersecurity requires balancing classical ML metrics (accuracy, F1-score) with cyber-physical constraints such as ECU compute budgets and transmission latency.
8. Explorer le projet & Code source (Explore Further)Explore Further
Accédez au dépôt officiel sur GitHub pour examiner le code source, l’architecture et les instructions d’exécution :Explore the official GitHub repository for source code, architecture specifications, and local execution guides:
Plateforme de gestion de services & Planification · Classification ML & Optimisation CP-SATEnterprise Service Management & Scheduling · ML Classification & CP-SAT Optimization
1. Vue d’ensemble (Overview)Overview
Plateforme intelligente de gestion de services d’entreprise (ITSM) associant la classification automatique de tickets par machine learning (TF-IDF + Régression Logistique avec Scikit-learn) et la planification mathématique optimale des équipes avec Google OR-Tools CP-SAT selon les compétences, disponibilités et délais SLA.Intelligent enterprise service-management (ITSM) platform coupling machine learning text classification (Scikit-learn TF-IDF + Logistic Regression) with exact discrete optimization (Google OR-Tools CP-SAT) to categorize support tickets and solve technician shift assignment under skills, availability, and SLA deadlines.
Conception et développement complet : entraînement et validation du modèle de classification NLP de tickets, formulation mathématique du problème d’affectation sous Google OR-Tools CP-SAT avec équilibrage de charge, API FastAPI asynchrone et interface moderne Next.js / TypeScript.End-to-end design and software development: training and evaluating the ticket classification NLP model, mathematical formulation of technician assignment under Google OR-Tools CP-SAT with workload balancing, asynchronous FastAPI backend, and Next.js / TypeScript interface.
3. Fonctionnement & Architecture (How It Works)How It Works
Chaque ticket entrant est analysé par un pipeline TF-IDF + Régression Logistique qui prédit sa catégorie et son niveau d’urgence avec un score de confiance étalonné. Le moteur d’optimisation OR-Tools CP-SAT affecte les tickets du backlog aux intervenants qualifiés et disponibles, en maximisant le respect des délais SLA et en équilibrant la charge hebdomadaire.Incoming service requests are processed by a TF-IDF + Logistic Regression pipeline that infers category and urgency with calibrated confidence scores. The OR-Tools CP-SAT engine then assigns backlog tickets to qualified, available agents, optimizing SLA compliance and balancing weekly workload distributions.
Choix d’un modèle ML transparent et ultra-rapide (<10 ms) avec Scikit-learn pour la catégorisation sans dépendance cloud coûteuse, couplé à un solveur de satisfaction de contraintes CP-SAT pour garantir formellement l’adéquation compétences-tâches et l’équité de charge.Chose a lightweight, interpretable Scikit-learn ML pipeline for ultra-fast (<10ms) local inference, coupled with CP-SAT constraint programming to formally guarantee skill alignment and strict workload limits.
5. Évaluation & Mesures (Evaluation)Evaluation
Évaluation des métriques de classification (Accuracy, F1-score macro) sur jeux de test et tests de robustesse du solveur CP-SAT face à des pics d’arrivée de tickets sous contraintes d’indisponibilité d’agents.Evaluated text categorization metrics (Accuracy, macro F1-score) across test splits and benchmarked CP-SAT solver responsiveness during ticket surges and sudden technician unavailability.
6. Limites identifiées (Limitations)Limitations
Évalué sur des jeux de données d’incidents synthétiques réalistes pour la démonstration. L’intégration avec des annuaires d’entreprise LDAP/Okta n’est pas implémentée dans ce prototype.Evaluated on synthetic ITSM incident logs for demonstration. Enterprise identity integration (LDAP/Okta SSO) is outside the prototype scope.
La synergie entre modélisation statistique (machine learning probabiliste) et recherche opérationnelle (optimisation exacte déterministe) permet d’automatiser des flux opérationnels complexes tout en conservant une garantie formelle de faisabilité.Combining probabilistic machine learning with deterministic operations research provides reliable automation with formal feasibility guarantees.
8. Explorer le projet & Code source (Explore Further)Explore Further
Accédez au dépôt officiel sur GitHub pour examiner le code source, l’architecture et les instructions d’exécution :Explore the official GitHub repository for source code, architecture specifications, and local execution guides:
Logiciel de gestion métier assisté par l’IA · Projet de stageAI-assisted business software · Internship project
1. Vue d’ensemble (Overview)Overview
Tadbir AI est une plateforme web intégrée conçue pour centraliser et automatiser les processus administratifs essentiels d’une entreprise : facturation, suivi client, gestion des stocks et reporting analytique. Le système vise à réduire la saisie manuelle et les erreurs humaines en intégrant l’intelligence artificielle dans les flux documentaires quotidiens.Tadbir AI is an integrated business management platform developed to centralize and automate core administrative operations: invoicing, customer tracking, inventory and reporting. The goal was to reduce manual entry bottlenecks by embedding AI into everyday document workflows.
Stagiaire en ingénierie IA / logicielle et team leader au sein de l’équipe de développement. J’ai coordonné les points techniques de l’équipe, participé à la structuration du backend Django REST, et pris en charge l’intégration de l’extraction automatique de champs par l’API Gemini ainsi que la logique de validation des données importées depuis des feuilles de calcul.Team Leader and AI / Software Engineering Intern within the development team. I coordinated technical tasks, contributed to the Django REST backend, and spearheaded document-field extraction using Gemini alongside spreadsheet validation workflows.
3. Fonctionnement & Architecture (How It Works)How It Works
Le flux combine un frontend Next.js/TypeScript et une API Django REST. Lorsqu’un document (facture, reçu) est importé, un appel structuré extrait les champs clés (montants, dates, identifiants). Ces données passent par un module de vérification de cohérence métier avant d’être soumises à une interface de revue humaine (human-in-the-loop) qui valide l’enregistrement dans la base de données.The architecture pairs a Next.js/TypeScript client with a Django REST API. When an invoice or spreadsheet is uploaded, structured extraction parses key attributes (totals, line items, dates). Data passes through schema validation rules before surfacing in a human-in-the-loop review UI for final confirmation.
Choix d’une approche hybride "IA + validation humaine" plutôt qu’une automatisation opaque à 100%, garantissant la conformité comptable. Utilisation de Django REST pour la robustesse du modèle relationnel et d’un typage strict en TypeScript sur le frontend.Selected a human-in-the-loop paradigm over fully autonomous processing to maintain accounting precision. Chose Django REST for relational integrity and TypeScript for interface reliability.
5. Évaluation & Mesures (Evaluation)Evaluation
Tests fonctionnels menés sur des jeux de factures et tableaux types. L’extraction a permis de pré-remplir les formulaires en réduisant significativement le temps de saisie, tandis que la validation humaine a systématiquement intercepté les ambiguïtés de mise en page.Functional testing across standardized invoice layouts demonstrated substantial time savings in form completion, with human review catching irregular formatting edge cases.
6. Limites identifiées (Limitations)Limitations
La précision dépend fortement de la qualité de numérisation des documents d’entrée. Les documents manuscrits ou très dégradés nécessitent une correction manuelle complète.Extraction fidelity varies on low-resolution scans. Handwritten or highly unstructured documents require full manual entry.
L’importance de concevoir des interfaces d’édition simples pour les corrections humaines : un modèle d’IA n’a de valeur pratique en entreprise que si ses incertitudes sont faciles à inspecter et corriger par les utilisateurs.Designing frictionless fallback interfaces is just as vital as model accuracy: AI delivers business value only when review workflows are intuitive.
8. Explorer le projet & Code source (Explore Further)Explore Further
Accédez au dépôt officiel sur GitHub pour examiner le code source, l’architecture et les instructions d’exécution :Explore the official GitHub repository for source code, architecture specifications, and local execution guides:
Ce projet dépasse le cadre du notebook isolé pour construire un pipeline complet d’ingénierie machine learning autour du jeu de données IBM Telco Customer Churn, visant à identifier les clients à risque d’attrition.This project moves beyond an isolated notebook to construct an end-to-end MLOps pipeline on the IBM Telco Customer Churn dataset, predicting subscriber attrition risks.
Projet individuel mené de bout en bout : exploration des données, ingénierie des variables, entraînement et comparaison de modèles, suivi avec MLflow, conteneurisation Docker et mise en place de tests statistiques de dérive.Sole developer: data preparation, feature engineering, model benchmarking, MLflow tracking, Docker containerization, FastAPI endpoint development, and drift monitoring.
3. Fonctionnement & Architecture (How It Works)How It Works
Le pipeline s’appuie sur DVC pour versionner les données et les étapes. MLflow enregistre les hyperparamètres, métriques et artefacts de modèle. Le meilleur modèle est packagé dans une image Docker servant une API REST FastAPI (/predict). Un script de monitoring calcule les tests Kolmogorov-Smirnov (KS) et le Population Stability Index (PSI) sur les données entrantes.DVC versions datasets and pipeline stages. MLflow tracks hyperparameters, metrics and the model registry. The selected model is packaged into a Docker container serving FastAPI endpoints. Continuous monitoring scripts compute Kolmogorov-Smirnov (KS) tests and Population Stability Index (PSI) scores to detect distribution drift.
Choix de Scikit-learn pour la transparence des métriques et la rapidité d’inférence. Priorisation du rappel (recall) sur la précision pour maximiser la détection des départs clients, tout en contrôlant le coût des faux positifs.Prioritized recall over precision to catch high-churn risks while managing false-positive intervention costs. Selected FastAPI for lightweight asynchronous inference.
5. Évaluation & Mesures (Evaluation)Evaluation
Évaluation sur jeu de test indépendant avec courbes ROC-AUC et matrices de confusion. Les tests KS et PSI simulent des dérives artificielles pour vérifier le déclenchement des alertes de réentraînement.Benchmarked on a holdout split using ROC-AUC and confusion matrices. Simulated synthetic distribution shifts to confirm drift detection thresholds.
6. Limites identifiées (Limitations)Limitations
Exécution et tests réalisés en environnement local conteneurisé. Le déploiement cloud (AWS/GCP) est documenté dans le dépôt mais non maintenu en continu pour des raisons de coût.Validated in local Docker execution. Cloud deployment pipelines are documented but not maintained live to avoid idle hosting costs.
Le code de modélisation ne représente qu’une petite fraction du travail en MLOps : la reproductibilité des environnements et la surveillance continue des données sont les véritables garants de la pérennité d’un modèle.Model training code is only a fraction of the real-world challenge; reproducible environments, clean pipelines, and drift detection ensure true operational reliability.
8. Explorer le projet & Code source (Explore Further)Explore Further
Accédez au dépôt officiel sur GitHub pour examiner le code source, l’architecture et les instructions d’exécution :Explore the official GitHub repository for source code, architecture specifications, and local execution guides:
Intelligence de tarification e-commerce sur 1M+ transactions · DuckDB & ProphetE-Commerce Pricing Intelligence on 1M+ Transactions · DuckDB & Prophet
1. Vue d’ensemble (Overview)Overview
Application analytique construite autour du jeu public Online Retail II (>1 million de transactions). Elle explore la segmentation RFM, la classification ABC-XYZ, les prévisions de revenus avec Prophet et les corrélations prix-demande dans un tableau de bord web interactif.Analytical application built on the Online Retail II dataset (>1 million transactions). It integrates RFM customer segmentation, ABC-XYZ inventory classification, Prophet revenue forecasting, and price-demand correlation analysis in an interactive dashboard.
Conception et développement complet : requêtes analytiques vectorisées sous DuckDB pour le calcul de métriques sur 1M+ lignes en millisecondes, API FastAPI et visualisations dynamiques Chart.js.Full-stack development: authored vectorized analytical queries in DuckDB processing 1M+ records in milliseconds, FastAPI backend, and Chart.js dynamic visualizations.
3. Fonctionnement & Architecture (How It Works)How It Works
DuckDB exécute les calculs de cohortes, de valeur client (CLV) et de segmentation RFM directement en mémoire. Les séries temporelles de ventes sont agrégées pour alimenter un modèle de prévision Prophet, tandis que l’élasticité prix-demande est explorée par modélisation statistique.DuckDB executes cohort analysis, customer lifetime value (CLV), and RFM segmentation directly in memory. Aggregated transaction time series feed into Prophet forecasting models while price-demand relationships are modeled statistically.
Utilisation de DuckDB comme moteur analytique in-process pour éliminer la latence d’une base de données externe tout en offrant des performances SQL analytiques de pointe sur des millions d’enregistrements.Selected DuckDB as an embedded analytical engine to avoid database overhead while delivering sub-80ms analytical query speeds on over a million records.
5. Évaluation & Mesures (Evaluation)Evaluation
Validation de la vitesse d’exécution SQL (requêtes sous les 80ms sur 1M+ transactions) et contrôle de la cohérence statistique des clusters clients.Benchmarked query performance (<80ms response time on 1M+ rows) and verified statistical consistency across customer segmentation clusters.
6. Limites identifiées (Limitations)Limitations
Les corrélations observées entre prix et demande sont empiriques et ne constituent pas une démonstration de causalité commerciale.Price-demand correlations are observational and do not demonstrate causal commercial elasticity.
L’optimisation des calculs au niveau du moteur analytique (colonnes vectorisées) est indispensable pour garantir une fluidité parfaite sur des volumes de transactions importants.Vectorized columnar query design is the single most effective lever for delivering real-time analytical exploration over high-volume transactional data.
8. Explorer le projet & Code source (Explore Further)Explore Further
Accédez au dépôt officiel sur GitHub pour examiner le code source, l’architecture et les instructions d’exécution :Explore the official GitHub repository for source code, architecture specifications, and local execution guides:
Aide à la décision logistique sous contraintes · Programmation linéaire PuLP & Monte-CarloLogistics Decision Support under Constraints · PuLP Linear Programming & Monte Carlo
1. Vue d’ensemble (Overview)Overview
Tableau de bord interactif pour explorer des scénarios d’approvisionnement et d’allocation de ressources. Formulation en programmation linéaire, optimisation multi-objectifs, modélisation de l’incertitude par simulation de Monte-Carlo et analyses de sensibilité.Interactive decision-support dashboard for exploring procurement and resource allocation scenarios under operational constraints, using linear programming, multi-objective trade-offs, Monte Carlo simulation, and sensitivity analysis.
Formulation mathématique complète du problème d’allocation sous contraintes de capacités d’entrepôts et de coûts de transport avec PuLP, génération de distributions stochastiques et interface interactive Streamlit / Plotly.Complete mathematical formulation of warehouse allocation and transportation cost minimization using PuLP, stochastic simulation distributions, and interactive Streamlit / Plotly UI.
3. Fonctionnement & Architecture (How It Works)How It Works
L’utilisateur configure les capacités logistiques, demandes clients et coûts unitaires. Le solveur de programmation linéaire résout le problème de transport optimal. Un module de simulation de Monte-Carlo évalue la robustesse de la chaîne logistique face aux aléas de demande.Users define supplier capacities, regional demands, and transport costs. The linear solver identifies optimal routing. A Monte Carlo module samples demand fluctuations to quantify supply chain resilience under stochastic shocks.
Utilisation de PuLP pour une formulation mathématique claire et portable, associée à des graphiques interactifs Plotly pour rendre les surfaces de compromis immédiatement compréhensibles.Selected PuLP for explicit, readable mathematical constraints and Plotly for intuitive visualization of multi-variable trade-off surfaces.
5. Évaluation & Mesures (Evaluation)Evaluation
Simulation de scénarios de rupture de stock et analyse de sensibilité sur les capacités d’approvisionnement.Tested stockout scenarios and sensitivity curves across constrained warehouse capacities.
6. Limites identifiées (Limitations)Limitations
Modèle de simulation à vocation méthodologique et pédagogique, fondé sur des paramètres synthétiques.Simulation-based study using synthetic operational parameters rather than live commercial fleet telemetry.
La programmation linéaire doit toujours être complétée par des analyses de robustesse face à l’incertitude pour être exploitable en environnement réel.Deterministic linear programming must be paired with stochastic sensitivity testing to deliver reliable operational decision guidance.
8. Explorer le projet & Code source (Explore Further)Explore Further
Accédez au dépôt officiel sur GitHub pour examiner le code source, l’architecture et les instructions d’exécution :Explore the official GitHub repository for source code, architecture specifications, and local execution guides: